Open weights voor murmel-flash-m-v5: Nederlandse spraakherkenning van 128M parameters die je zelf draait
Architectuur, benchmarks, snelheid, hoe je het draait, en de licentie
Twee weken geleden beloofde ik open weights voor murmel-flash-m-v5, het kleinste model uit onze familie van Nederlandse spraakherkenningsmodellen. Ze staan nu op Hugging Face: 512 MB aan fp32-safetensors, met een Python-pakket op PyPI (pip install murmel-flash) en een commandoregeltool. Op de processor van een laptop draait het ongeveer 19 keer realtime, dus een uur audio duurt zo'n drie minuten, helemaal op je eigen hardware. Dit stuk gaat over hoe het gebouwd is, hoe het scoort op open Nederlandse benchmarks, hoe je het draait en de licentie.
Waarom is lokaal draaien belangrijk? Spraak is een van de gevoeligste soorten data die organisaties verwerken: vergaderingen, interviews, telefoongesprekken, medische consulten. Als het model op je eigen hardware draait, vallen een hele reeks vragen weg: geen externe verwerker, geen doorgifte buiten de grens, geen bewaarbeleid waar je geen grip op hebt. Voor spraakherkenning zou dat de standaard moeten zijn, niet de uitzondering.
Wat je kunt downloaden
murmel-flash-m-v5 is een spraakherkenningsmodel van 128 miljoen parameters voor Nederlands, met Engels als tweede taal. Het is het kleinste lid van de murmel-flash-familie, de modellen achter murmel.nl.
Het is geen aangepaste versie van een bestaand model. Onder de motorkap zit een encoder in FastConformer-stijl met een hybride CTC/attention-decoder, gebouwd in gewone PyTorch en vanaf nul getraind op Nederlandse spraak. De CTC-kop werkt ook als scheidsrechter: de attention-decoder schrijft alleen tekst waar CTC het eens is dat er spraak is, en dat is een groot deel van de reden dat het model stil blijft bij ruis. Een SentencePiece-tokenizer van 4.096 stukjes met taaltags laat het per venster wisselen tussen Nederlands en Engels.
Direct beschikbaar:
- Leesbare tekst: leestekens, hoofdletters en getallen als cijfers, met Nederlands of Engels automatisch herkend, ook als iemand halverwege van taal wisselt.
- Tijdstempels per woord: elk woord met begin- en eindtijd, klaar voor ondertitels of zoeken.
- Eigen woordenlijsten: namen, plaatsen en vakjargon die goed gespeld moeten worden, tijdens het decoderen versterkt via een prefixboom in de beam search, zonder opnieuw te trainen.
- Elk bestand, elke lengte: wav, mp3, m4a, mp4 en meer. Opnames van een uur worden bij pauzes opgeknipt en weer tot zinnen samengevoegd.
- Live transcriptie vanaf je microfoon, terwijl je praat.
- Een lokale server (
murmel-flash serve) met het veelgebruikte/v1/audio/transcriptions-endpoint, zodat bestaande tools er zonder codewijzigingen naar kunnen wijzen.
Hoe het het doet
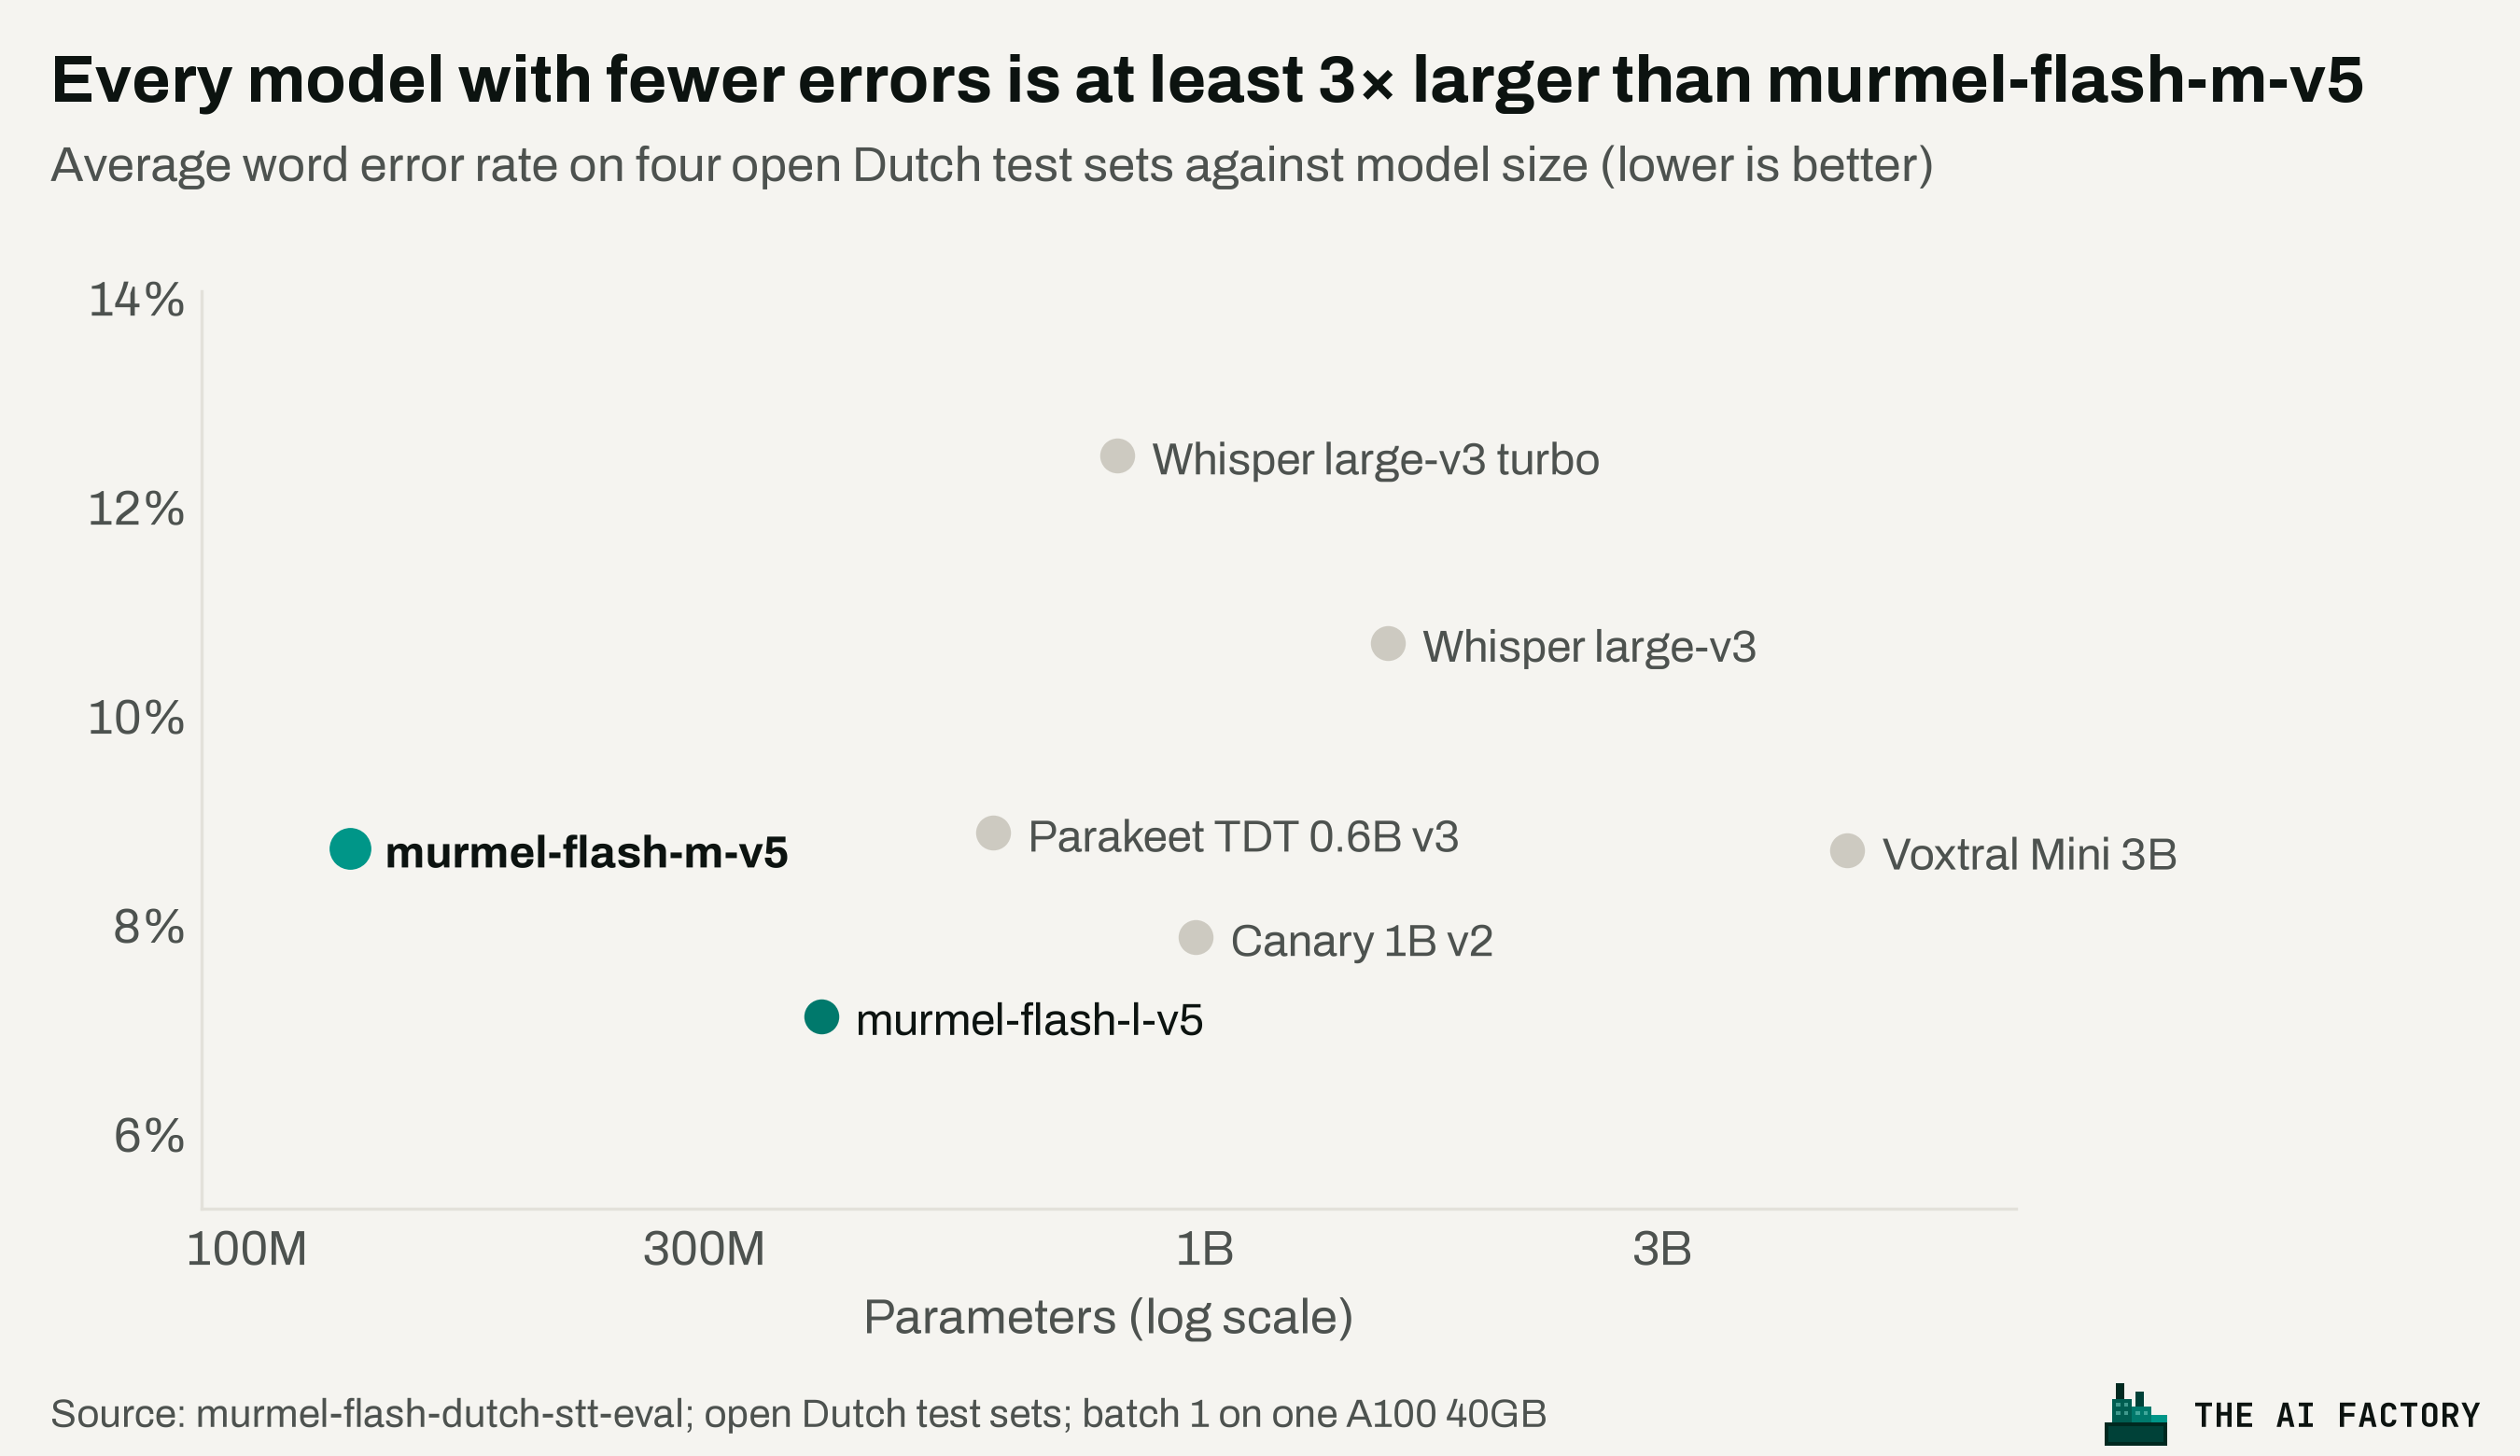
Op vier veelgebruikte open Nederlandse testsets (FLEURS, Common Voice 17, Multilingual LibriSpeech en VoxPopuli) heeft murmel-flash-m-v5 gemiddeld 8,7% van de woorden fout. Daarmee doet het niet onder voor modellen die meer dan 30 keer zo groot zijn, en is het beter dan modellen die tot 12 keer zo groot zijn. Elk model dat minder fouten maakt, is minstens drie keer zo groot. Het haalt ongeveer 19 keer realtime op de processor van een laptop en 100 tot 150 keer op één T4-GPU; alleen CTC-decodering (--mode ctc) is nog eens ongeveer drie keer sneller, tegen een klein verlies aan nauwkeurigheid. Elk model in de vergelijking kreeg dezelfde audio, één clip tegelijk, met dezelfde tekstnormalisatie. De volledige tabel en methode staan in het stuk over Murmel v5.
Twee dingen waar ik extra blij mee ben:
- Stilte blijft stil. Op opnames van regen, verkeer, keukens of een zoemende koelkast schrijft het maar bij 4% van de clips iets op. Veel spraakmodellen verzinnen daar tekst, vaak ondertitelaftitelingen als "Bedankt voor het kijken!".
- Getallen zoals je ze zelf zou typen. "Nul zes twaalf drie vier vijf zes zeven acht" wordt 06 12345678, "tien elf A B" wordt 1011 AB, en "drieëntwintig euro vijftig" wordt € 23,50.
Aan de slag
Het zijn drie stappen:
- Installeer het pakket met
pip install murmel-flash(Python 3.10 tot en met 3.13). De code staat op GitHub. - Vraag toegang aan op de modelpagina op Hugging Face: vul het korte formulier in en accepteer de licentie. Aanvragen worden met de hand beoordeeld.
- Draai
murmel-flash interview.mp3en het transcript verschijnt. Het model wordt de eerste keer automatisch gedownload.
Vanuit Python zijn het drie regels:
from murmel_flash import Transcriber, load_audio

tr = Transcriber.from_pretrained()
res = tr.transcribe(load_audio("interview.mp3"))
print(res["text"])
Je krijgt de tekst, de segmenten en elk woord met zijn tijdstempels.
Wie het gratis mag gebruiken
Ik wil dat dit model voor zoveel mogelijk mensen bruikbaar is. Daarom is het gratis voor:
- particulieren;
- onderwijs en open onderzoek aan scholen, universiteiten en onderzoeksinstellingen;
- kleine organisaties, met minder dan 10 medewerkers en minder dan €1 miljoen omzet, ook voor commercieel gebruik. Zzp'ers en kleine bedrijven kunnen het in hun eigen werk en producten inbouwen.
Overheden van elke omvang, grotere organisaties en leveranciers die voor hen werken hebben een commerciële licentie nodig. Dat geldt voor ministeries, provincies, gemeenten en waterschappen. Ook wie murmel-flash als gehoste transcriptiedienst aanbiedt, heeft een licentie nodig. Iedereen, overheid inbegrepen, mag het eerst 30 dagen gratis evalueren.
Waarom ligt de grens daar? Grotere organisaties en overheden hebben het budget, en ze hebben meestal meer nodig dan een download: iemand die je kunt bellen als het misgaat, een verwerkersovereenkomst, hulp bij het inpassen in hun systemen. Met een licentie bieden we dat, en zo blijven we de volgende modellen trainen.
Interesse in een licentie, of in een van onze grotere, nauwkeurigere modellen op je eigen infrastructuur? Mail naar murmel@the-ai-factory.com, of lees meer in Murmel draaien op je eigen servers.
Wat er niet in zit
Het open model herkent geen sprekers, en het is het kleinste van onze modellen. Sprekerherkenning, het grotere murmel-flash-l-v5 (het nauwkeurigste model in onze benchmark) en koppelingen met Teams en Google Meet zijn beschikbaar op murmel.nl en via de Murmel API, op servers in Nederland.
Dank je wel
Dit model is beter dankzij iedereen die Murmel gebruikt en laat weten waar het fout gaat. Elke foutmelding, vraag en gedeelde opname laat zien waar het model nog struikelt. Nu de gewichten openbaar zijn, ben ik benieuwd wat je ermee bouwt, en waar het struikelt. Laat het me weten: allebei maken ze de volgende versie beter.
murmel-flash-m-v5 in het kort
- Wat het is: een Nederlands spraakherkenningsmodel van 128M parameters van The AI Factory, vanaf nul getraind, met Engels als tweede taal.
- Waar je het vindt: Hugging Face (gewichten), PyPI als
murmel-flash(pakket) en GitHub (code). - Draait op: de processor van een laptop, een GPU of een recente telefoon, volledig offline.
- Nauwkeurigheid: gemiddeld 8,7% woordfouten op vier open Nederlandse benchmarks.
- Licentie: gratis voor particulieren, onderwijs, onderzoek en kleine organisaties; overheden en grotere organisaties hebben een commerciële licentie nodig, na 30 dagen gratis evaluatie.
Vragen, ideeën of een project dat je wilt bespreken? Ik hoor graag van je: murmel@the-ai-factory.com.