Murmel v5: kleine, snelle Nederlandse spraakherkenning die stil blijft als niemand praat
De nieuwe murmel-flash-modellen, hoe ze het doen naast Whisper, NVIDIA en Mistral op open Nederlandse benchmarks, en wat er komt voor het kleinste model
Laat Whisper large-v3 turbo een opname horen van regen, verkeer of een zoemende koelkast, en twee van de drie keer schrijft het toch iets op. "TV Gelderland 2021". "Bedankt voor het kijken!". "ZANG EN MUZIEK", tientallen keren achter elkaar. Op dezelfde clips zonder spraak schrijft het nieuwe model van 128M parameters bij 4% iets op, en nooit iets dat op een ondertitelaftiteling lijkt.
Dat is een van de dingen waar ik aan heb gewerkt voor versie 5 van murmel-flash, de familie spraakherkenningsmodellen achter murmel.nl. Dit stuk gaat over wat er veranderd is, hoe de modellen het doen op openbare Nederlandse benchmarks naast OpenAI, NVIDIA en Mistral, en wat er komt: open weights voor het kleinste model komen binnenkort.
Vanaf nul gebouwd, voor Nederlands
murmel-flash is geen aangepaste Whisper. Het is een eigen, compacte architectuur, gebouwd in gewone PyTorch en vanaf nul getraind op Nederlandse spraak, met Engels als tweede taal. Daardoor kan ik het vormen rond wat Nederlandse gebruikers echt zeggen: namen, samenstellingen, getallen, vergaderingen die van het ene onderwerp naar het andere gaan, en mensen die door elkaar heen praten.
Versie 5 komt in twee maten. murmel-flash-m-v5 heeft 128 miljoen parameters, klein genoeg voor de processor van een laptop. murmel-flash-l-v5 heeft er 397 miljoen en is de nauwkeurigste. Ter vergelijking: Whisper large-v3 heeft er 1,55 miljard.
Hoe het het doet op open Nederlandse benchmarks
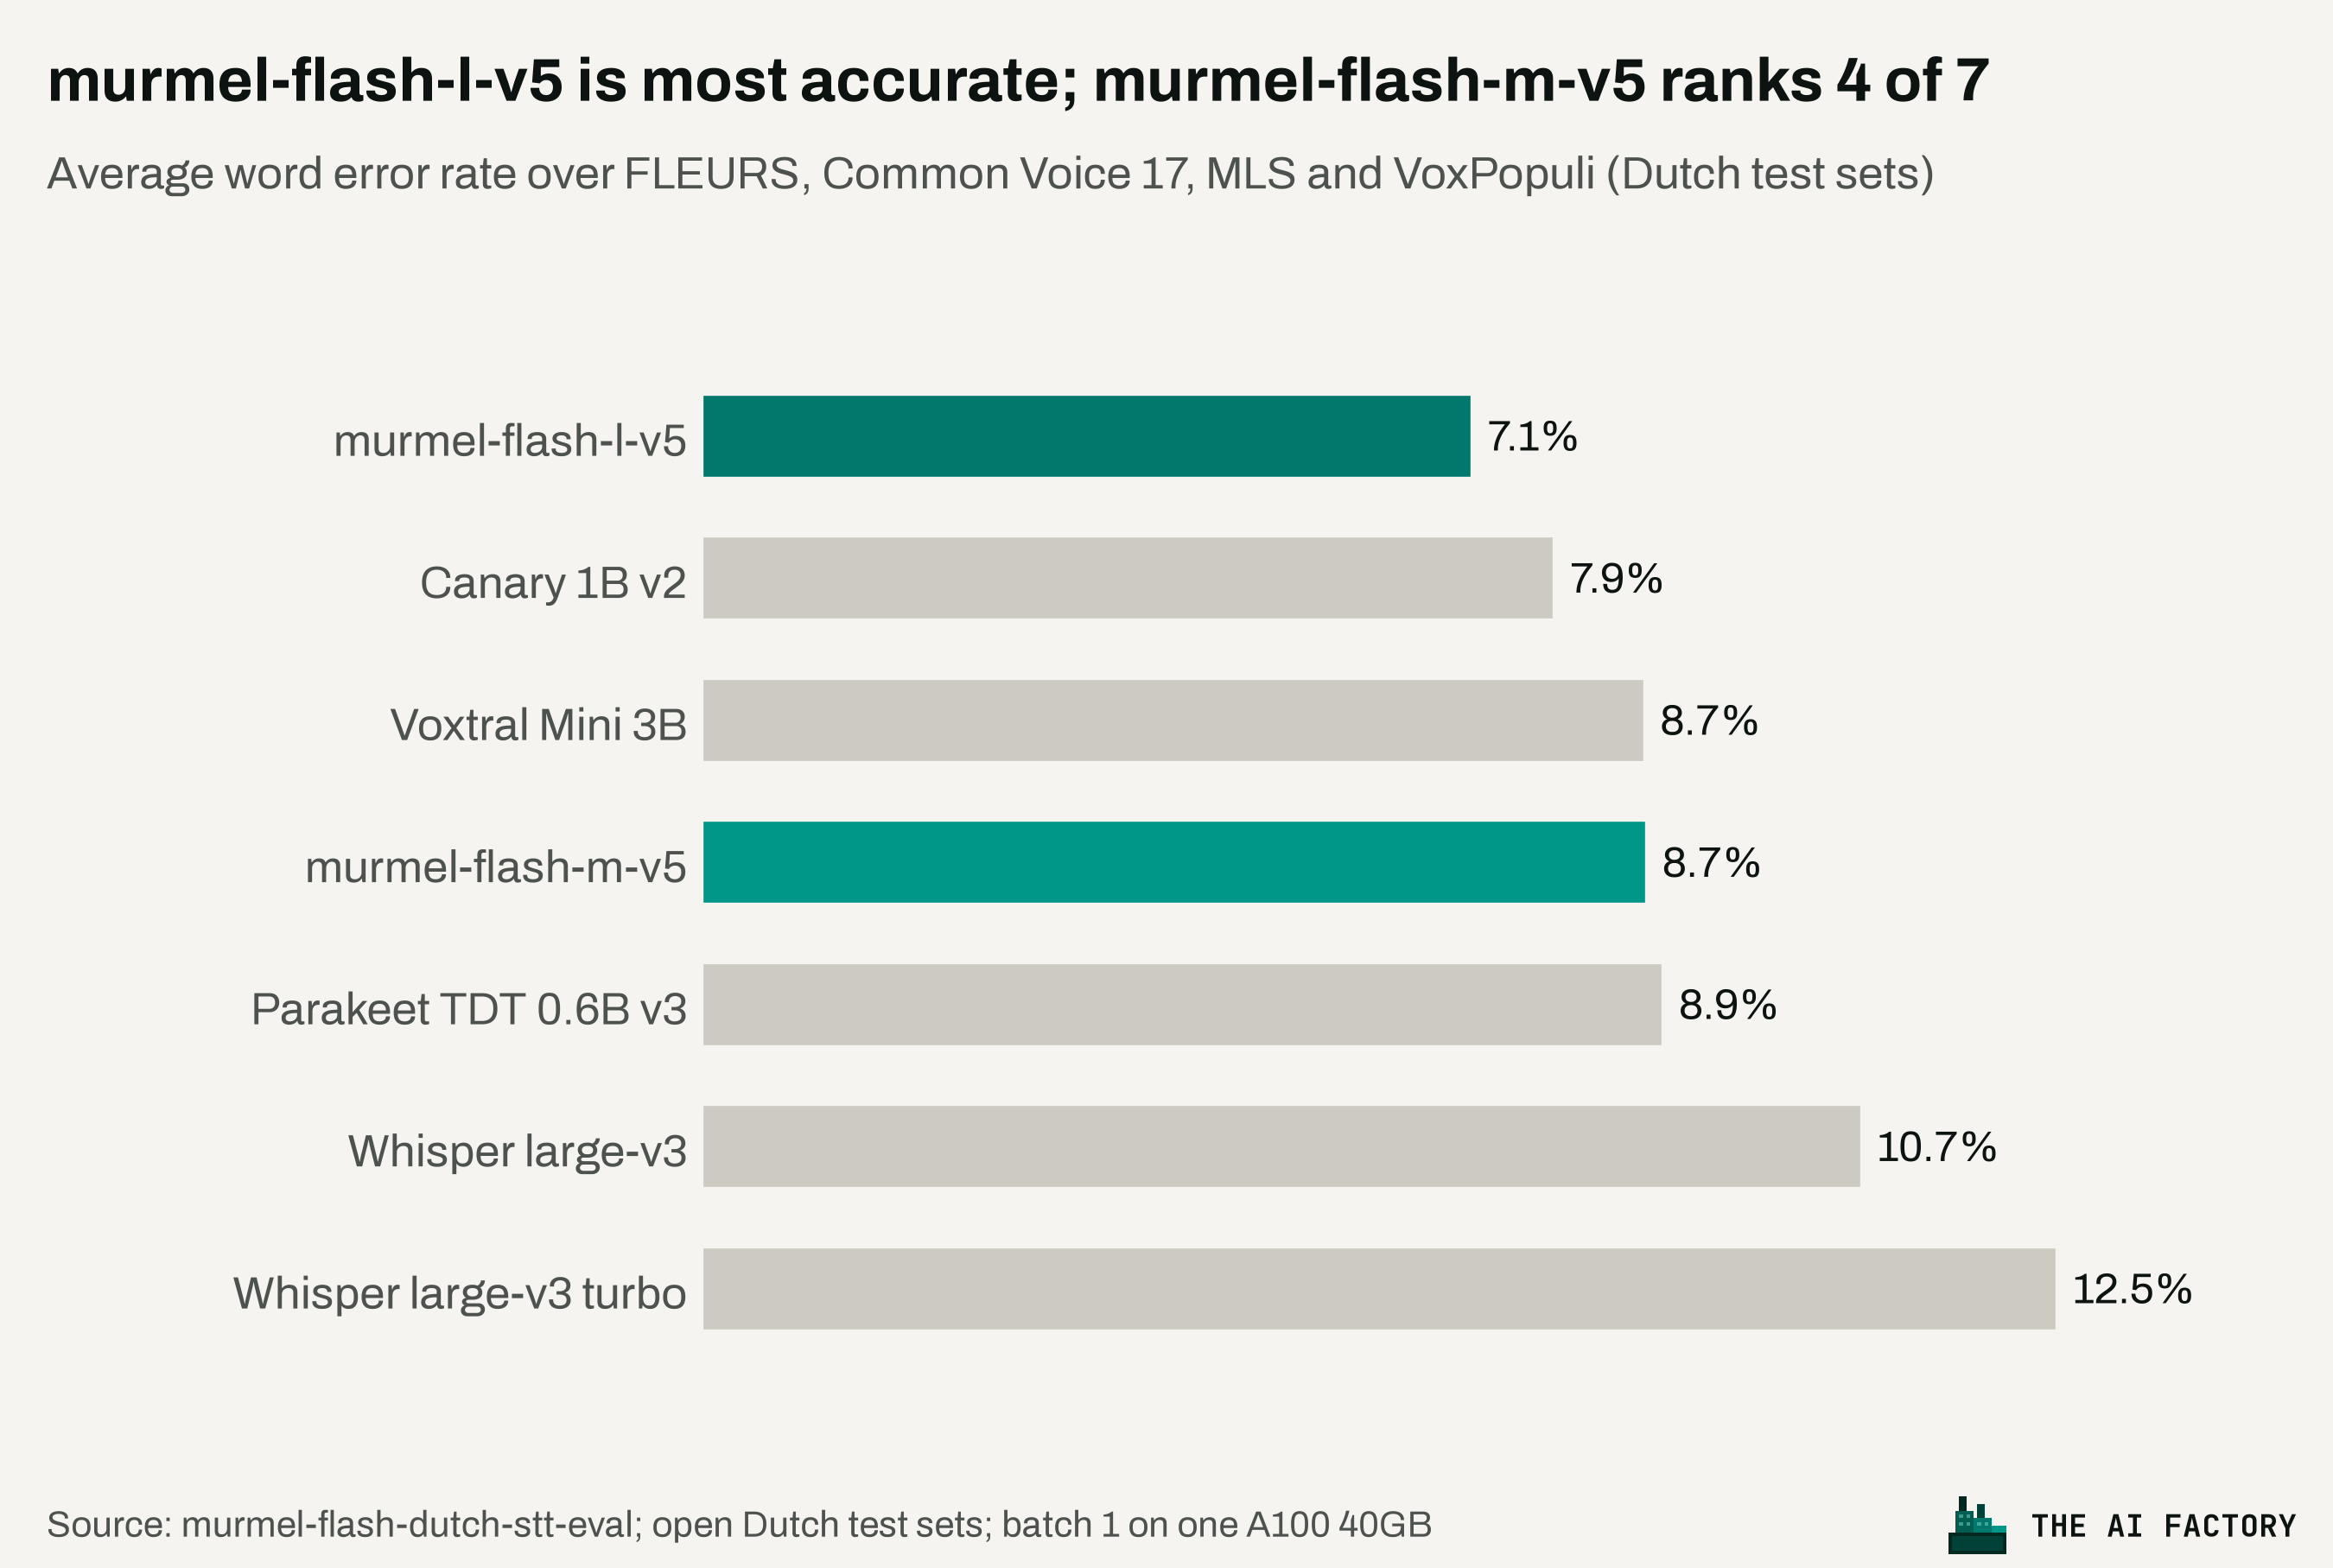
Ik heb zeven modellen vergeleken op vier veelgebruikte open Nederlandse testsets: FLEURS, Common Voice 17, Multilingual LibriSpeech en VoxPopuli, samen ongeveer 15.800 clips. Elk model krijgt precies dezelfde audio, één clip tegelijk, op dezelfde GPU, en wordt beoordeeld met dezelfde tekstnormalisatie, elk met de eigen aanbevolen decodering en zonder extern taalmodel. De evaluatiecode deel ik later ook, zodat iedereen het kan nadoen.
| Model | Maker | Params | FLEURS | Common Voice 17 | MLS | VoxPopuli | Gemiddeld |
|---|---|---|---|---|---|---|---|
| murmel-flash-l-v5 | The AI Factory | 397M | 7,8 | 3,7 | 7,5 | 9,4 | 7,1 |
| Canary 1B v2 | NVIDIA | 978M | 6,0 | 4,4 | 9,8 | 11,2 | 7,9 |
| Voxtral Mini 3B | Mistral AI | 4.7B | 5,8 | 5,0 | 9,8 | 14,1 | 8,7 |
| murmel-flash-m-v5 | The AI Factory | 128M | 9,7 | 5,1 | 9,4 | 10,6 | 8,7 |
| Parakeet TDT 0.6B v3 | NVIDIA | 600M | 7,9 | 4,9 | 11,1 | 11,5 | 8,9 |
| Whisper large-v3 | OpenAI | 1.55B | 5,6 | 4,2 | 9,8 | 23,1 | 10,7 |
| Whisper large-v3 turbo | OpenAI | 809M | 6,0 | 5,8 | 9,6 | 28,4 | 12,5 |
Woordfoutpercentage in %, lager is beter. Genormaliseerd: kleine letters, geen leestekens, getallen uitgeschreven, stopwoorden verwijderd.
Kort samengevat:
- murmel-flash-m-v5 maakt 18% minder fouten dan Whisper large-v3, terwijl het 12 keer kleiner en 5 keer sneller is.
- Tegenover Whisper large-v3 turbo maakt het 30% minder fouten, op een zesde van de grootte.
- Het doet het even goed als Voxtral Mini van Mistral, een model dat 37 keer zo groot is.
- murmel-flash-l-v5 maakt de minste fouten van alle zeven: 33% minder dan Whisper large-v3 op een kwart van de grootte, en 10% minder dan Canary van NVIDIA op minder dan de helft van de grootte.
- Op debatspraak (VoxPopuli) maakt murmel-flash minder dan de helft van de fouten van Whisper large-v3.
Elk model dat minder fouten maakt dan murmel-flash-m-v5 is minstens drie keer zo groot.
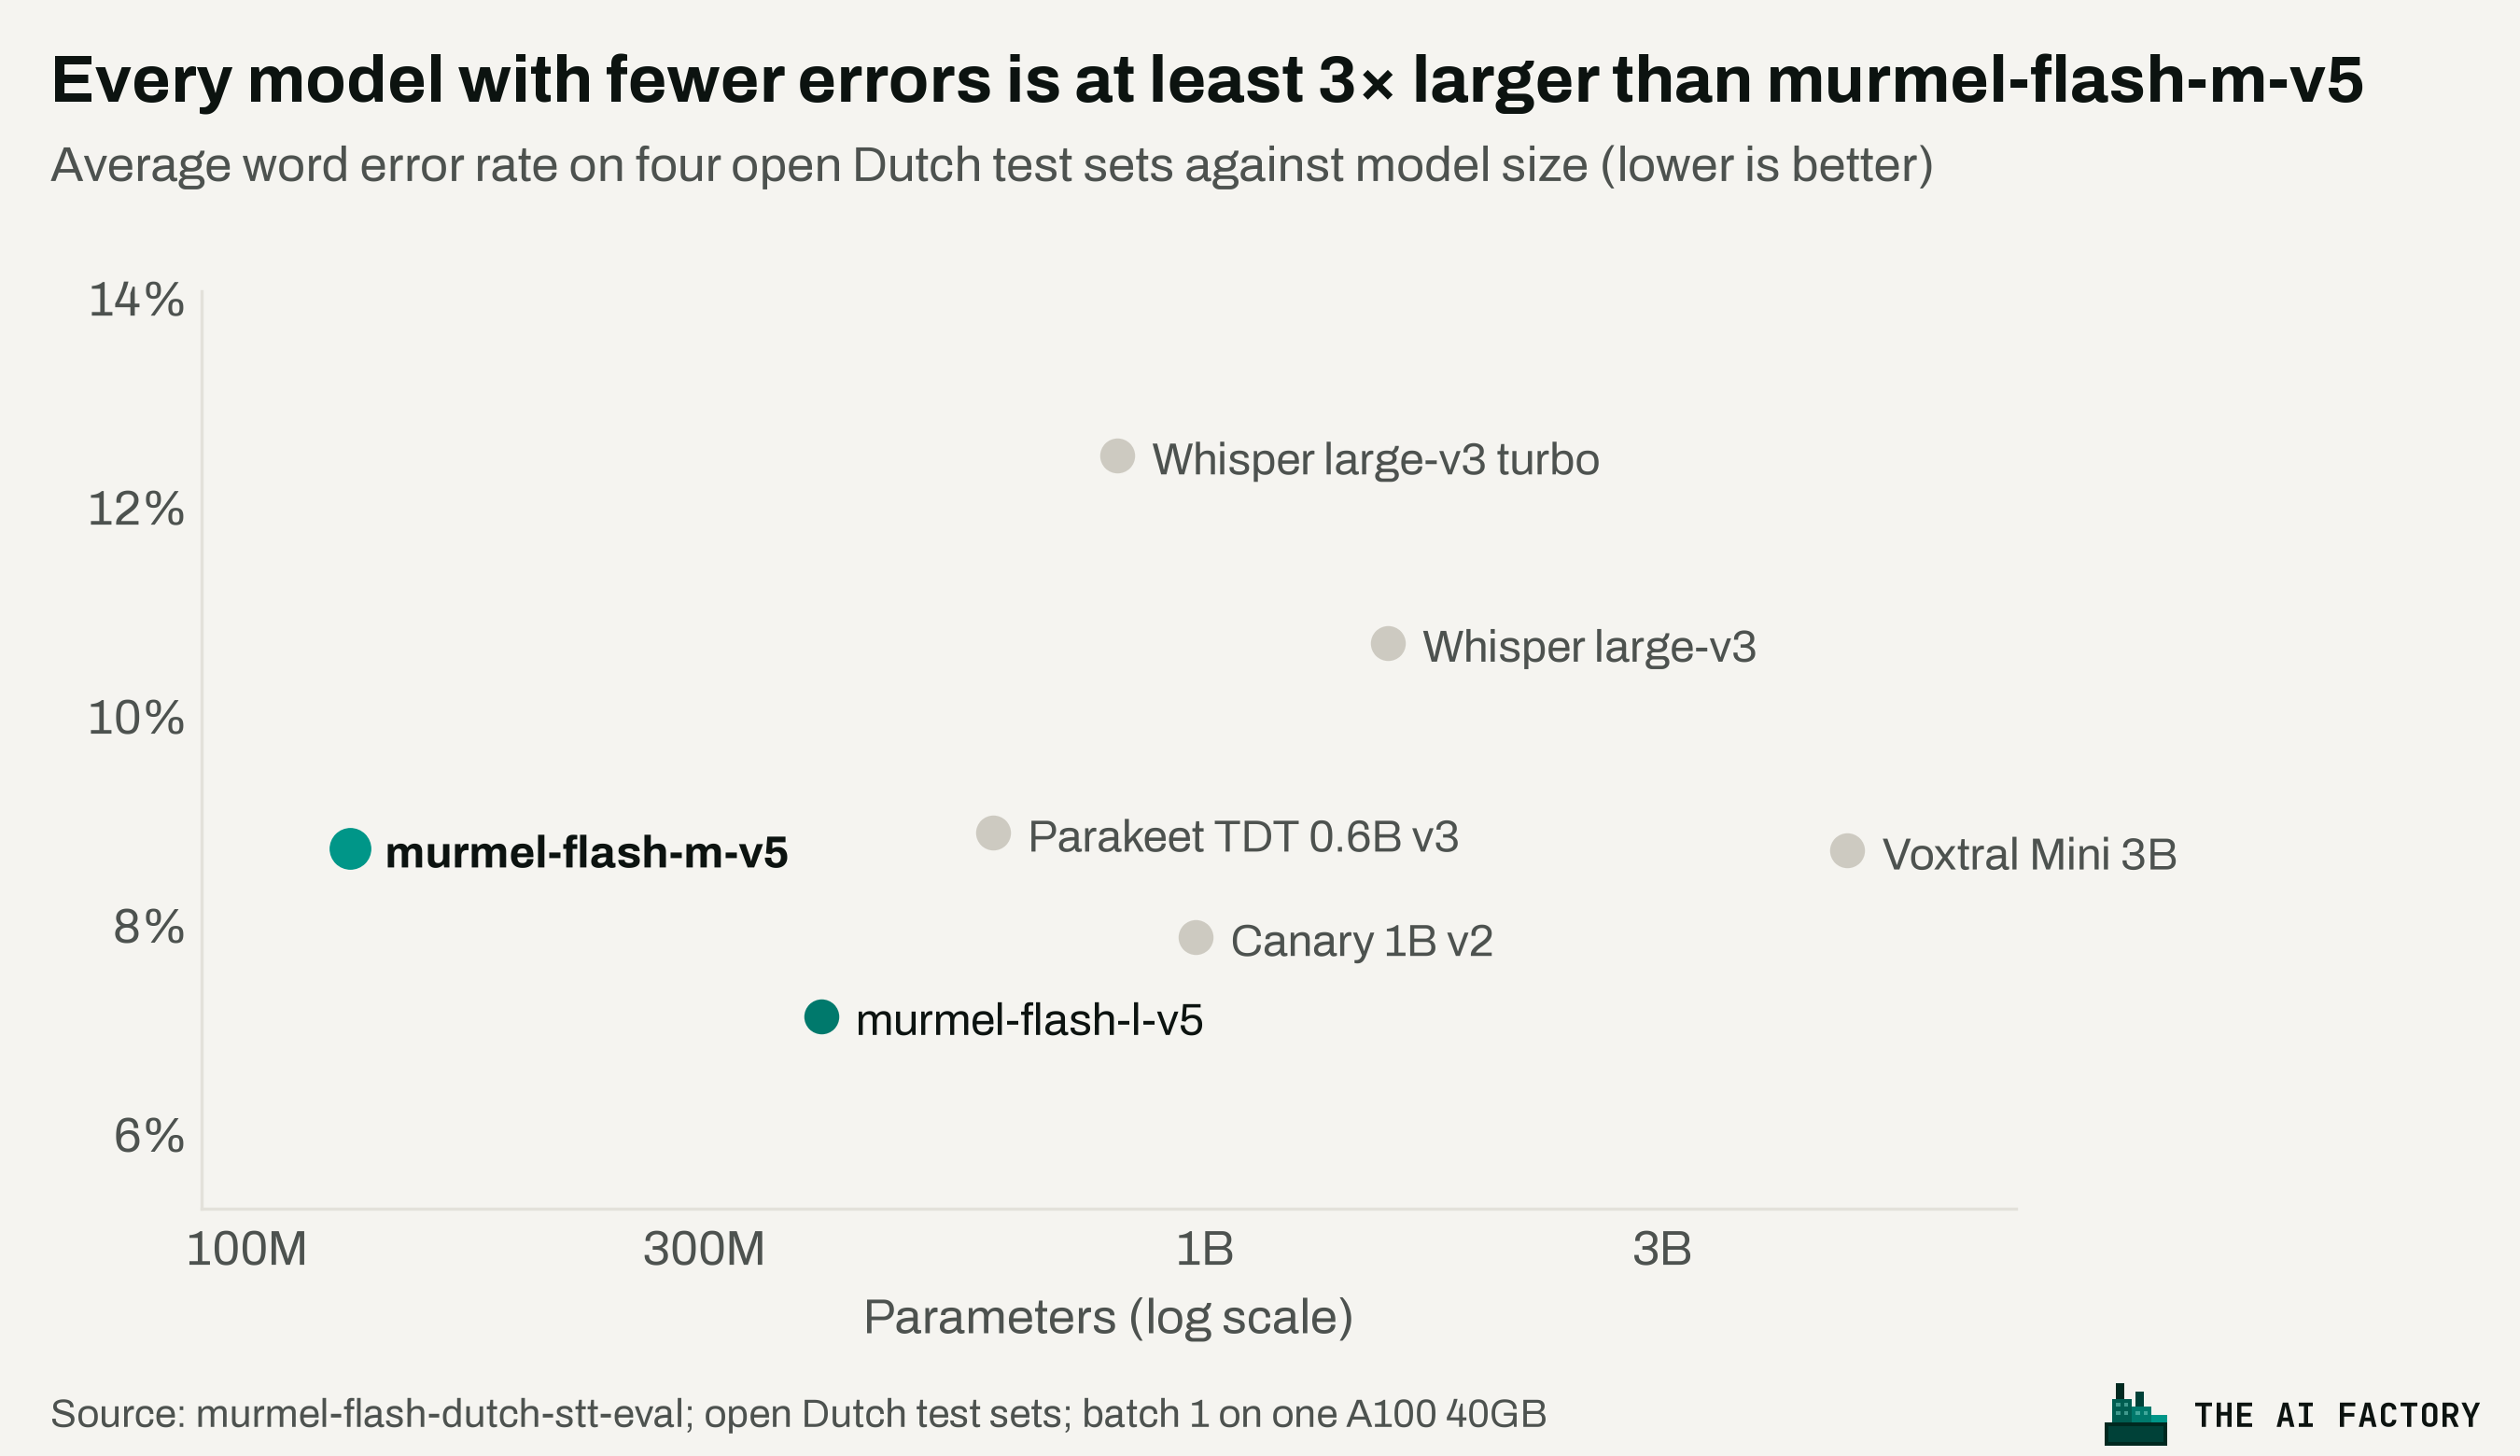
Eerlijk is eerlijk: op schone, voorgelezen zinnen (FLEURS en Common Voice) zijn Whisper en Canary nog beter dan het kleine model. Het verschil zit waar mensen vrijer praten. Op VoxPopuli, opnames van debatten in het Europees Parlement, heeft Whisper large-v3 bijna één op de vier woorden fout; murmel-flash één op de tien.
Stilte hoort stil te blijven
De vervelendste fout van spraakherkenning is geen verkeerd verstaan woord. Het is tekst die uit het niets verschijnt. Bij muziek, ruis of stilte valt Whisper vaak terug op wat er in ondertitels staat: aftitelingen, bedankjes voor het kijken, de naam van een regionale omroep.
Dat heb ik direct getest: clips zonder spraak van verkeer, regen, keukens, menigtes, machines, gezoem en stilte, die de modellen geen van alle eerder gezien hadden.
| Model | Schrijft tekst op audio zonder spraak |
|---|---|
| Whisper large-v3 turbo | 68% van de clips |
| murmel-flash-m-v5 | 4% |
| murmel-flash-l-v5 | 3% |
Wat murmel-flash nog wel op die clips schrijft is kort: een "ja", een "dank u wel". Twee dingen hebben hier gezorgd. De decoder krijgt een scheidsrechter: een tweede, snellere kop die het eens moet zijn dat er spraak is voordat er tekst uitkomt. En in versie 5 is het model getraind op uren ruis met lege transcripten, zodat het geleerd heeft dat niets gezegd ook niets opgeschreven betekent.
Getallen zoals je ze zelf zou typen
Telefoonnummers, postcodes, rekeningnummers en bedragen zijn waar transcripten meestal fout gaan, en waar een fout echt iets kost. murmel-flash schrijft uitgesproken getallen in de vorm die je zelf zou typen:
| Je zegt | murmel-flash schrijft |
|---|---|
| nul zes twaalf drie vier vijf zes zeven acht | 06 12345678 |
| tien elf A B | 1011 AB |
| N L eenennegentig A B N A nul vier één zeven één zes vier drie nul nul | NL91 ABNA 0417 1643 00 |
| drieëntwintig euro vijftig | € 23,50 |
| vijftien procent | 15% |
Op een eigen testset van echte opnames met uitgesproken getallen heeft murmel-flash-m-v5 11,5% van de woorden fout en het grotere model minder dan 10%, tegenover 14,9% voor Whisper large-v3.
Dank voor jullie input
Veel dank aan iedereen die Murmel gebruikt en laat weten waar het fout gaat. Jullie foutmeldingen, vragen, en de opnames die gebruikers van murmel.nl zelf wilden delen, laten precies zien waar het model nog struikelt. Elke versie is daardoor beter.
Versie 4 was een grote stap: het leerde omgaan met allerlei soorten audio, van vergaderingen en telefoongesprekken tot interviews, colleges en uitzendingen. Versie 5 is de volgende stap. Na de hoofdtraining ben ik gaan zoeken naar de woorden die het model nog fout had, zoals namen, leenwoorden, samenstellingen en zeldzame woorden, heb ik daar nieuwe, gevarieerde trainingszinnen omheen geschreven, en het model daar gericht op getraind. Blijf feedback geven: die bepaalt waar ik hierna aan werk.
Binnenkort: open weights voor het kleine model
Open weights voor murmel-flash-m-v5 komen binnenkort, gratis voor niet-commercieel gebruik. De evaluatiecode deel ik later ook, zodat iedereen de benchmarks kan nadoen. Volg Murmel om op de hoogte te blijven.
Wil je murmel-flash commercieel gebruiken, in een product, een dienst of de eigen werkprocessen van je organisatie, of heb je een van de grotere, nauwkeurigere modellen nodig op je eigen servers? Mail naar murmel@the-ai-factory.com, dan zoeken we een licentie die past.
De grotere modellen blijven beschikbaar via murmel.nl en de gehoste API, op servers in Nederland. En de volgende, grotere generatie zit al in de training.
Murmel v5 in het kort: nu beschikbaar op murmel.nl
Murmel v5 draait vanaf vandaag voor iedereen die murmel.nl gebruikt. Geen nieuw account of instellingen nodig: elke nieuwe transcriptie gaat door het nieuwe model.
- Wat het is: murmel-flash v5, een Nederlands spraakherkenningsmodel (spraak naar tekst) van The AI Factory, vanaf nul getraind op Nederlandse spraak, met Engels als tweede taal.
- Waar je het gebruikt: op murmel.nl, om opnames van vergaderingen, interviews, telefoongesprekken, colleges en podcasts uit te schrijven, met sprekerherkenning, en om ondertitels voor video te maken. Ontwikkelaars gebruiken hetzelfde model via de Murmel API.
- Privacy: audio wordt verwerkt op servers in Nederland.
- Nauwkeurigheid: murmel-flash-l-v5 maakt de minste fouten van de zeven geteste modellen op open Nederlandse benchmarks (gemiddeld 7,1% woordfouten op FLEURS, Common Voice 17, MLS en VoxPopuli).
- Open weights: murmel-flash-m-v5 (128M parameters) komt binnenkort als open weights, gratis voor niet-commercieel gebruik.
Wat ik geleerd heb
Grootte is niet alles. Een model van een twaalfde van de grootte van Whisper, zorgvuldig getraind voor één taal, kan het op die taal verslaan. Maar de details bepalen of mensen een transcript vertrouwen: geen tekst uit het niets, getallen in de goede vorm, namen goed gespeld, en de keuze om audio op je eigen apparaat te houden. Dat krijg je niet van een groter model. Dat krijg je door naar de fouten te kijken, één voor één, en ze op te lossen.
Wil je het proberen, er iets mee bouwen, of laten weten waar het fout gaat? Ik hoor graag van je: info@the-ai-factory.com.